雖然樹是一種結構上比較簡單的圖,但樹有時候還是太複雜了!在基礎圖論 / 樹中介紹的最基本的存樹方法就只會存下每個節點的鄰居有誰,然而當我們想要知道遠在天邊的兩個節點之間的資訊,比方說它們是不是互為祖先子孫,或甚至是對一條指定的路徑、一個子樹做奇怪的事情,只靠在樹上一格一格的爬實在是太沒效率了。
要能夠在樹上做到更多事情,一種方法是想辦法把樹變成一個序列,畢竟序列比樹更簡單嘛,但是隨便把節點列出來當然沒什麼用,我們得要找出一些有意義的順序才能加以利用,DFS 順序出奇不意地就是一個很好用的順序。
回顧一下對樹 DFS 的過程:我們會從樹的根節點開始走,當走到一個節點時,往它的一個子節點走、走完這個子節點為根的整個子樹後,再往第二個子節點走,……,直到把所有子節點走完為止,我們會回到這個節點、離開這個子樹,再也不會回來。因此,DFS 的過程中每個節點都有個進入的時間與離開的時間,進入與離開的意思具體來說是我們進入或離開了這個節點為根的子樹,我們把進入節點 $v$ 的時間寫作 $in[v]$、離開的時間寫作 $out[v]$。
vector<int> g[MAXN];
int in[MAXN], out[MAXN];
int cnt = 0; // 現在時間
void dfs(int now, int p) {
    in[now] = ++cnt; // 進入 now
    for (int i : g[now]) {
        if (i == p) continue;
        dfs(i, now);
    }
    out[now] = ++cnt; // 離開 now
}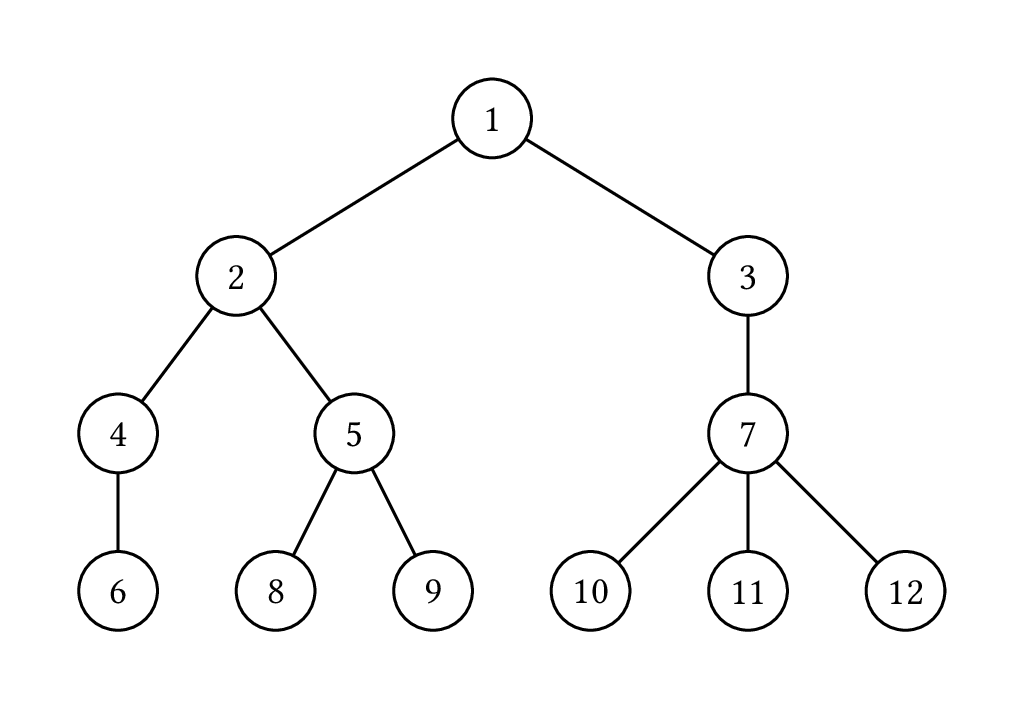
舉例來說,假設在以上這張圖 DFS 時我們優先走左邊的子節點,那麼 DFS 時的進入、離開順序就是
\[
\color{blue}1,
\color{blue}2,
\color{blue}4,
\color{blue}6,
\color{red}6,
\color{red}4,
\color{blue}5,
\color{blue}8,
\color{red}8,
\color{blue}9,
\color{red}9,
\color{red}5,
\color{red}2,
\color{blue}3,
\color{blue}7,
\color{blue}{10},
\color{red}{10},
\color{blue}{11},
\color{red}{11},
\color{blue}{12},
\color{red}{12},
\color{red}7,
\color{red}3,
\color{red}1 \]
藍色順序代表進入、紅色代表離開,所以我們存下來的 $in[v],out[v]$ 會是
\[
\begin{array}{c|cccccccccccc}
v & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 & 10 & 11 & 12 \\ \hline
in[v]&1&2&14&3&7&4&15&8&10&16&18&20 \\
out[v]&24&13&23&6&12&5&22&9&11&17&19&21
\end{array}
\]
其中 $in[v]$ 就對應到上面那個序列裡 $\color{blue}v$ 的位置、$out[v]$ 對應到 $\color{red}v$ 的位置。把 DFS 的過程寫下變成序列的樣子就稱為樹壓平。
樹壓平與子樹息息相關,最厲害的地方就是當進入一個節點 $v$ 之後,一定要走完 $v$ 的整個子樹才會離開 $v$,也就是說所有 $v$ 的子孫都出現在 $in[v]$ 和 $out[v]$ 之間。
\[
\color{blue}1,
\underbrace{\color{blue}2,
\color{blue}4,
\color{blue}6,
\color{red}6,
\color{red}4,
\overbrace{\color{blue}5,
\color{blue}8,
\color{red}8,
\color{blue}9,
\color{red}9,
\color{red}5}^{\text{以 \(5\) 為根的子樹}},
\color{red}2}_{\text{以 \(2\) 為根的子樹}},
\color{blue}3,
\color{blue}7,
\color{blue}{10},
\color{red}{10},
\color{blue}{11},
\color{red}{11},
\color{blue}{12},
\color{red}{12},
\color{red}7,
\color{red}3,
\color{red}1 \]
這有什麼用呢?一個很簡單的應用是判斷兩個節點的祖孫關係。
[Tutorial] 祖孫關係
給定一棵有根樹,節點 $1$ 為根。請回答 $q$ 個詢問,每筆詢問會給定兩個相異的節點 $x_i, y_i$,請回答 $x_i$ 是否為 $y_i$ 的祖先。
條件限制
- $2 \leq n \leq 2 \times 10^ 5$
- $1 \leq q \leq 5 \times 10^ 5$
在有了樹壓平以後,就可以很輕鬆的判斷 $x$ 和 $y$ 的祖孫關係了!只要滿足這個條件:
\[ in[x] \leq in[y] \land out[y] \leq out[x] \]
那麼 $x$ 就是 $y$ 的祖先。為了某些時候的方便,我們會說一個節點自己也是自己的祖先,如果想要自己不算是自己的祖先,就只要把等號都拿掉就好了,在上面的算法裡,不同節點的 $in[\cdot]$ 或 $out[\cdot]$ 一定會不一樣。這樣一來,只要先樹壓平過,就可以只花 $O(1)$ 的時間得知兩個節點的祖孫關係了。
我們剛才把進入和離開的時間都記錄下來了,並且它們的時間點都不重複,但大多時候我們其實不需要讓離開的時間點是一個獨立的時間點,反而進入的時間點不是連續數字會有一點麻煩,這個時候可能就會這樣寫:
void dfs2(int now, int p) {
    in[now] = ++cnt; // 進入 now
    for (int i : g[now]) {
        if (i == p) continue;
        dfs2(i, now);
    }
    out[now] = cnt; // 離開 now
}
差別只在於離開節點時沒有把 cnt 增加。這樣寫的話,離開一個節點時就不會把時間增加,樹壓平的結果可以看成是我們只在進入節點的時候把它寫下來,以上面那棵樹當例子的話就是
\[ 1,2,4,6,5,8,9,3,7,10,11,12 \]
也就是只把剛才的序列只挑藍色的出來。而 $in[\cdot]$、$out[\cdot]$ 會是:
\[
\begin{array}{c|cccccccccccc}
v & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 & 10 & 11 & 12 \\ \hline
in[v] &1&2&8&3&5&4&9&6&7&10&11&12\\
out[v]&12&7&12&4&7&4&12&6&7&10&11&12
\end{array}
\]
其中 $in[v]$ 就是 $v$ 在上面那個序列的出現位置,$out[v]$ 則是 $v$ 的子樹裡最大的 $in[\cdot]$,也就是 $v$ 的子樹中最後一個 DFS 走到的節點被走到的時間點。和剛才離開節點時也會 ++cnt 的版本差不多,上面判斷祖孫關係的式子還是可以用,只不過要注意不同節點的 $out[\cdot]$ 可能會一樣,而一個節點 $v$ 的子樹區間是 $[in[v], out[v]]$。
\[ 1,\underbrace{2,4,6,5,8,9}_{\text{以 2 為根的子樹}},3,7,10,11,12 \]
這樣好用的點在哪裡呢?舉個簡單的例子,有一棵樹有根樹,每個節點 $v$ 帶有權重 $w_v$,現在我們想要詢問以某個節點為根的子樹總和。假設我們把只記錄進入的樹壓平結果記作 $t_1,t_2,\dots,t_n$,也就是 $t_{in[v]}=v$,那麼因為 $v$ 的子樹就是 $t_{in[v]},t_{in[v]+1},\dots,t_{out[v]}$,因此我們只要計算
\[ \sum_{i=in[v]}^{out[v]} w_{t_i} \]
就可以得到以 $v$ 為根的子樹總和了,如果想成是先算好一個序列 $a_i=w_{t_i}$,問題就是找 $a$ 的一個區間總和,用前綴和與差分中的前綴和就可以 $O(1)$ 計算。用離開時會把時間增加的版本的樹壓平當然也可以這樣用,只要讓 $a_{out[v]}=0$ 就不會影響答案,但陣列長度會變兩倍長又有一堆地方用不到,就不太舒服。
讀者可能會覺得這個例子很殺雞用牛刀,為什麼不要在 DFS 過程中計算子樹總和,走完一個節點的所有子節點以後再把它們的子樹總和加起來就好了?的確這麼做是殺雞用牛刀,畢竟樹壓平本質上是把 DFS 的過程存下來,同一件事情能直接在 DFS 過程中完成也很合理,這裡只是想先給出「一個子樹在樹壓平的結果中會是一個連續區間」這個性質的使用方式大概會像什麼樣子,更複雜的題目才會真正的需要用到它。
考慮另外一個問題:有一棵有根樹,每個節點上面有權重,現在我們想要詢問從根節點出發到某個節點 $v$ 的路徑上,所有節點的權重總和。和剛剛一樣,其實也在 DFS 過程中計算就可以了,但現在我們要殺雞用牛刀。如果是在 DFS 過程中計算,那寫出來會長成這樣:
vector<int> g[MAXN];
int w[MAXN]; // 權重
int ans[MAXN]; // ans[v] = 根節點到 v 的路徑權重總和
int cur_sum = 0; // 根到目前節點的權重總和
void dfs(int now, int p) {
    cur_sum += w[now]; // now 加入了根到目前節點的路徑
    ans[now] = cur_sum;
    for (int i : g[now]) {
        if (i == p) continue;
        dfs(i, now);
    }
    cur_sum -= w[now]; // now 不再在根到目前節點的路徑上
}
比照剛剛「樹壓平就是把 DFS 過程存下來」的想法,DFS 的過程是
- 在進入 $v$,也就是時間點 $in[v]$ 時
cur_sum會增加 $w_v$。 - 在離開 $v$,也就是時間點 $out[v]$ 時
cur_sum會減少 $w_v$。
這裡的時間點用的是進入離開都會讓時間增加的版本,我們把每個時間點 cur_sum 發生的變化寫下來成 $a_1,a_2,\dots,a_{2n}$,也就是
\[ a_{in[v]}=w_v, \quad a_{out[v]}=-w_v \]
$a_1+a_2+\dots+a_{in[v]}$ 就是我們在計算 ans[v] 當下的 cur_sum,所以問題變成問 $a$ 的前綴和了!
以上我們介紹了一些很簡單的應用,不過在這些例子裡只有判斷祖孫關係會被直接這樣用出來,算子樹總和跟算路徑總和兩個都是殺雞用牛刀,這兩個用法必須結合之後章節會出現的線段樹等資料結構才會真的有用,在讀者學到更多工具以後,樹壓平會成為相當有用的武器。為了讓讀者有點概念,這裡放一個剛才的例子進化版的題目:
Subtree Queries
給一棵 $n$ 個節點的有根樹,每個節點帶有各自的權重,然後有 $q$ 筆詢問,詢問有兩種:
- 把某個節點 $s$ 的權重改成 $x$。
- 求某個節點 $s$ 為根的子樹中,所有節點的權重總和。
條件限制
- $n,q \leq 2 \times 10^5$
先假裝我們有一個很厲害的資料結構可以直接使用:這個資料結構可以維護一個陣列,它可以很快的修改陣列裡某個指定位置的值,並且很快的回答某個區間的總和。有了這個厲害的資料結構,我們就可以直接結合樹壓平解決這題:用這個資料結構維護我們剛才的陣列 $a$,修改 $s$ 的權重就是把 $a_{in[s]}$ 改成它的新權重,詢問 $s$ 子樹的總和就是問區間 $[in[s], out[s]]$ 的總和,就是這麼簡單。
這個資料結構究竟要怎麼辦到不是這篇文章的重點(BIT 與線段樹這些很有名的資料結構都可以做到),這個例子的目的只是為了讓讀者對樹壓平的強大之處有點概念。