在圖論基礎時,我們有提過最短路徑問題能用 BFS 解決。但那是在輸入圖不帶權的情況下,如果邊帶權,要怎麼處理呢?
更準確的來說,現在給定一張圖,有向或無向都可以,我們會希望能找到對於圖上給定的一組 $s$ 和 $t$,他們之間的所有路徑中,路徑權重總和最小的那條。
這個問題非常吻合日常的需求,也是演算法領域中相當重要的一個問題。就好比我們試圖把地圖想像成一張圖,那麼任何分歧點都可以是一個節點、而連著分歧點的道路就是圖上的邊。同時,這裡的道路也不會是等長的,也才會有帶邊權的需求。
那要怎麼解決有帶邊權的最短路徑問題呢?我們就一一來看看各種解決最短路徑的演算法們。
先來講講最短路徑演算法的理念,由於從 $s$ 走最短路徑到 $t$,我們中間可能也會經過其他點,那假設有個中間經過的點叫 $x$,應該沒什麼道理 $s$ 到 $x$ 不是最短路徑吧?因此,在算出 $s$ 到 $t$ 的最短路徑的同時,$s$ 到 $x$ 的最短路徑也會被決定出來。這也代表大多數的最短路徑演算法,在給定起點 $s$ 後,理論上是得一口氣得出 $s$ 到所有點的最短路徑的!
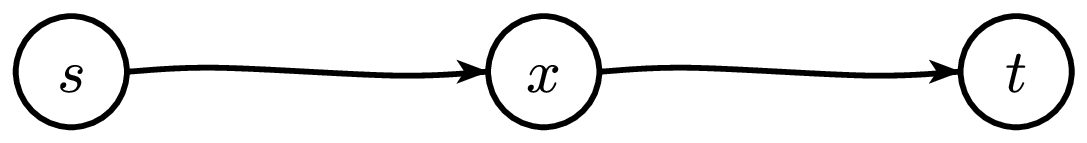
從這樣的觀點出發,由於最短路徑是所有點相輔相成的,想像上就變成在一開始,對於給定的所有可能的終點,我們都不知道抵達他們的路徑究竟有多長,而透過不斷發現新的道路,我們就能逐漸了解整張地圖,試圖決定出每個點的最短路徑。這也讓大多數的最短路徑演算法都會先「假設」所有點的最短路徑為無限大,再試圖「互相降低」彼此的最短路徑直到不能再降低為止。
在本文中
- 我們會以
dis[u]陣列來代表當前 $s$ 到 $u$ 的最短路徑。只要演算法執行結束,dis[]就會存著 $s$ 到每個點的確切最短路徑值。要注意我們總是假設這個陣列已經宣告,並已經初始化成全部都是無限大。 - 我們會用 $N$ 代表點數、$M$ 代表邊數。
- 我們會用
G[u]代表 $u$ 的所有鄰邊,且一條連到 $v$ 權重為 $w$ 的邊會以pair$(v, w)$ 的形式存在G[u]內。 - 我們會用
s代表最短路的出發點。 - 我們假設圖是有向的,因為無向圖可以直接拆成兩條有向邊來對待。
而為了方便起見,請讀者先假設邊權都是正值,畢竟「道路長度是負的」這種抽象的概念在理解演算法上會造成一些障礙,我們會在後續的文章再提起有負邊權的狀況。
再來介紹一個接下來每個演算法都會用到的概念──鬆弛。
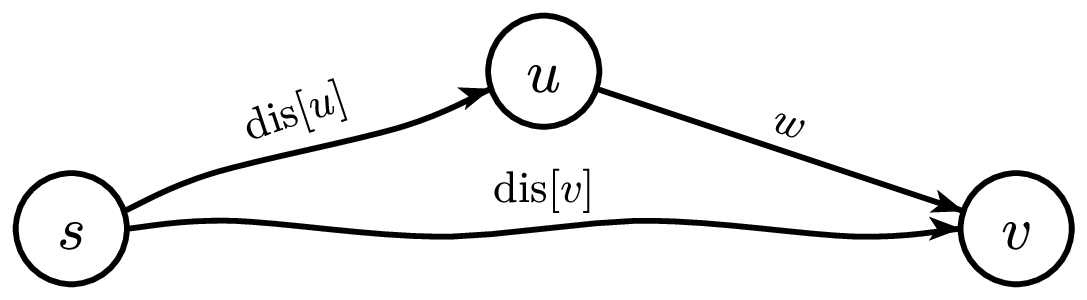
前面所謂「降低」最短路徑的想法其實相當單純:若現在有一條邊 $u \to v$ 的權重是 $w$,那麼當我們發現到 $v$ 的路徑比「先到 $u$、再走這條權重為 $w$ 的邊」還要短時,我們就可以直接更新到 $v$ 的最短路徑。
我們把這個動作叫做鬆弛(Relax)。如下圖所示:
如果寫成程式的話,就會是這種感覺:
if (dis[v] > dis[u] + w)
    dis[v] = dis[u] + w;
利用鬆弛的概念,我們就可以得到這種「發現了一條更短的捷徑」的想法,不斷更新各點的最短路徑。
既然有了鬆弛的概念,有一個簡單的最短路徑演算法就能因此誕生了,那就是 Bellman-Ford Algorithm。
概念也相當簡單:不斷看過圖中的每一條邊,每次都對看到的邊進行鬆弛,更新到不能再更新為止就停下來。
這時問題就來了:這樣要鬆弛幾輪才會結束啊?
想像中,只要看過第一輪邊,所有「最短路徑距離 $s$ 只需要一條邊 」的點都會在當下被決定好最短路徑;只要看過二輪邊,所有「最短路徑距離 $s$ 只需要兩條邊 」的點也都會在當下被決定好最短路徑。
那其實結論也就呼之欲出:一個點的最短距離再遠,他也只能使用 $N-1$ 條邊,所以我們只需要跑 $N-1$ 輪就可以得到所有點的最短路徑!
實作就如下面這段程式碼一樣簡短。
dis[s] = 0;
for (int i = 0; i < n - 1; ++i)
    for (int u = 0; u < n; ++u)
        for (auto [v, w] : G[u])
            if (dis[v] > dis[u] + w) // 鬆弛
                dis[v] = dis[u] + w;
時間複雜度也相當單純,就是 $O(N)$ 輪的 $M$ 次鬆弛,整體是 $O(NM)$。
Bellman-Ford 演算法雖然簡短,但他的時間複雜度非常的不理想,我們可以從中觀察到一些很浪費時間的地方:
- 在看過第一輪邊時,其實只有 $s$ 指向的點需要被鬆弛到而已,那對其他點的所有出邊進行鬆弛不就很浪費嗎?
- 如果一個點已經達到了最短路徑,那在他幫自己的所有出邊鬆弛一次過後,之後跟他有關的鬆弛不都很浪費時間嗎?
以上述的觀察為突破點,Dijkstra's 演算法對這個觀念做了一個巧妙的轉換,那就是:「我們每次找到候選池裡距離最短的點,將他從候選池拿出來,並對他的出邊進行鬆弛」。
什麼意思呢?
- 在開始前,所有點的最短距離都還沒被確定,因此所有點都在候選池內,並將大家的距離初始化成無限大。
- 做為演算法的開始,我們知道起點 $s$ 的距離是 $0$,因此將 $s$ 的距離設為 $0$。
- 接著我們開始進行 Dijkstra 的鬆弛操作,在第一輪鬆弛時,候選池內 $s$ 的距離是最小值(也就是剛剛賦予的 $0$),那我們就拿 $s$ 出來,對他的所有出邊進行鬆弛;
- 這時候,$s$ 鄰居的距離都靠著 $s$ 對他們的鬆弛變短,因此在第二輪鬆弛時,我們再次從候選池中選出距離最短的點將其拿出候選池(注意到 $s$ 已經被拿出候選池所以不會再次選到 $s$),然後對他的所有出邊進行鬆弛。
- 如此反覆的做下去。
這樣做有什麼好處呢?Dijkstra 的觀察是這樣的,在池子裡距離最短的點,他的最短距離其實已經被確定、不會再更新了,所以拿它出來是最有效率的,因為它再也不會被重新更新後、被丟回池子內。
這個觀察的正確性聽起來直觀,但還是可以簡單解釋一下為什麼:因為邊權都是正的,既然我們拿出來的點已經是距離最小的點了,其他點的再怎麼鬆弛,也不可能可以「製造出」比他短的距離吧!
有了這樣的想法,要實作 Dijkstra's 演算法其實相當的簡單,只要每次跑個迴圈找到當前距離最小的點就好:
vector<bool> vis(n);
dis[s] = 0;
for (int _ = 0; _ < n; ++_) {
    int best = -1;
    for (int i = 0; i < n; ++i)
        if (!vis[i] && (best == -1 || dis[i] < dis[best]))
            best = i;
    // 到此為止,best 是所有還沒被拿出來的點中,距離最小的點
    vis[best] = true;
    for (auto [v, w] : G[best])
        if (dis[v] > dis[best] + w)
            dis[v] = dis[best] + w;
}
下圖是一個實際跑在一張圖上的範例:
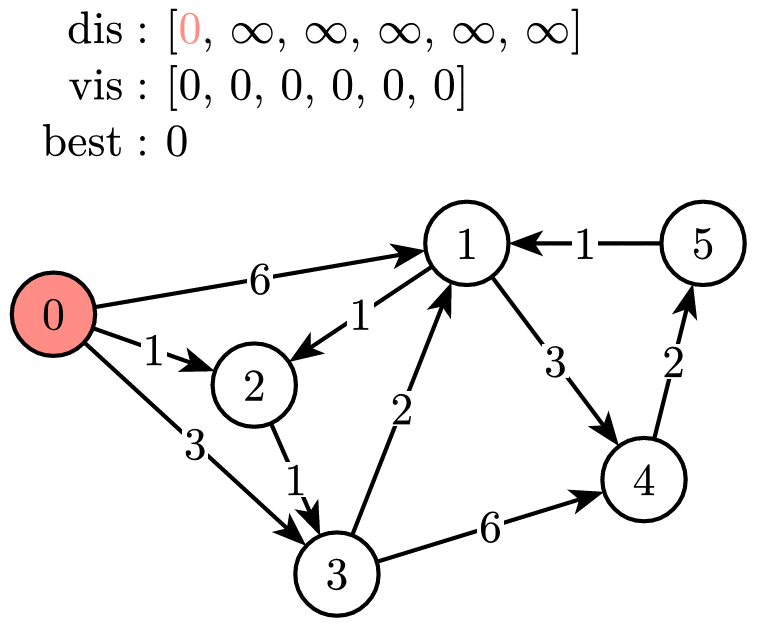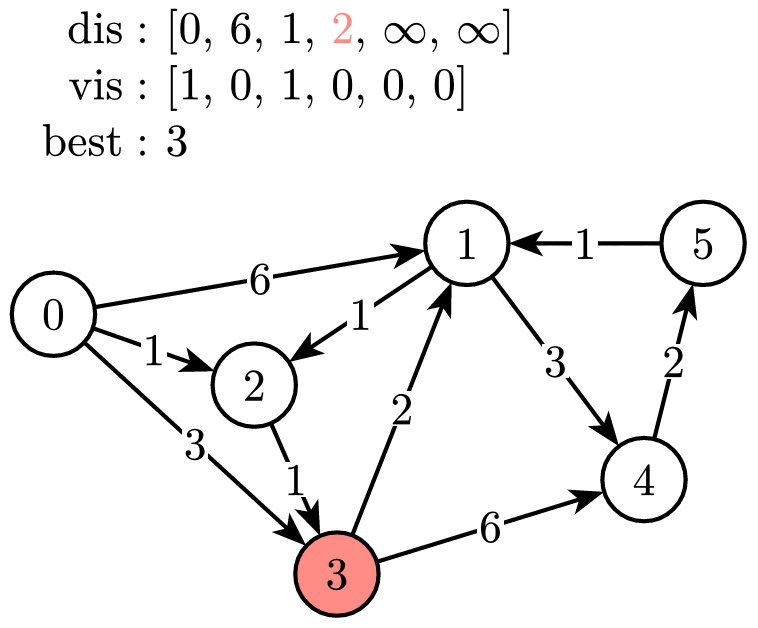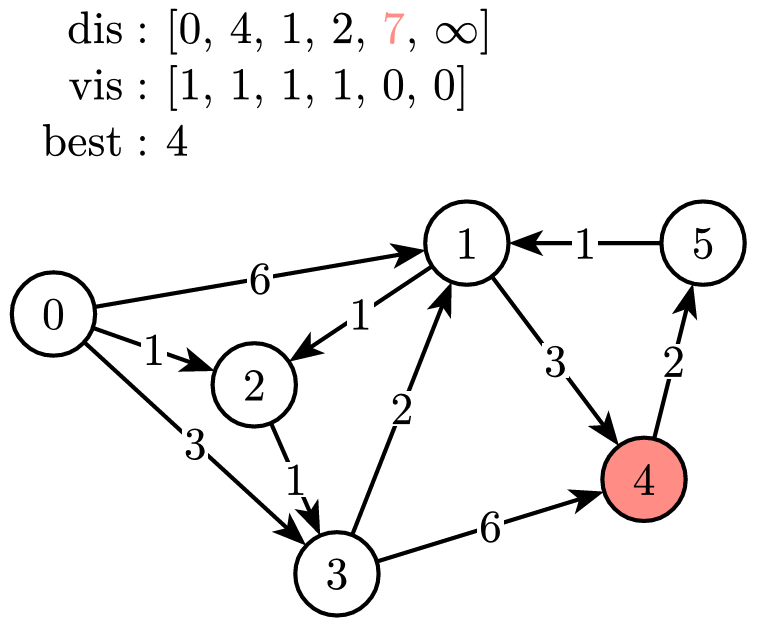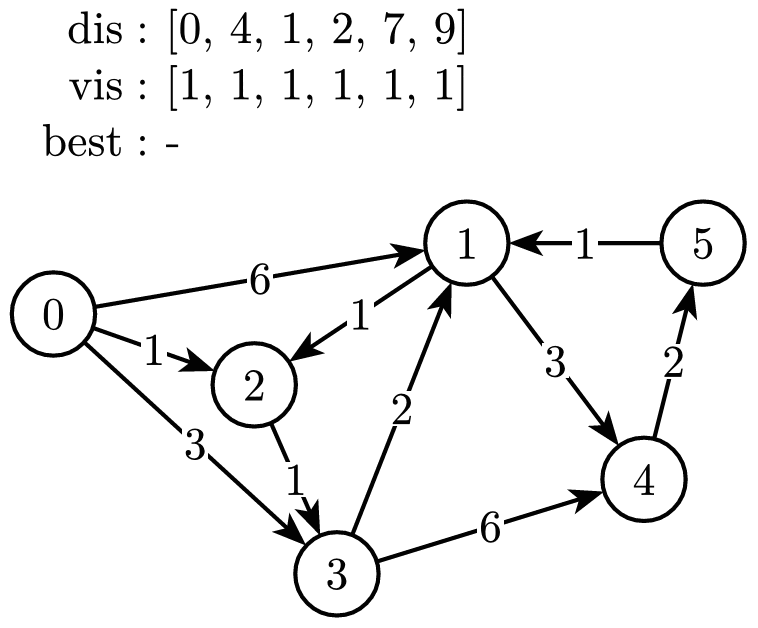
那 Dijkstra's 演算法的複雜度究竟變得多好呢?要知道我們已經強調過,每個點在從池子被拿出來的瞬間,他就再也不會被更新了,換個角度講就是每個點只會被拿出來一次而已,而每次要花 $O(N)$ 的時間找到距離最小的點,所以整體是 $O(N^2 + M)$。
仔細想想,如果有一個「動態更新數值、動態回報最小值」的資料結構,不就可以更快了嗎?沒錯,其實就只是把所謂的「候選池子」,利用 priority_queue 加速!
不過,有一個細節似乎是 priority_queue 不容易達成的:我們要怎麼動態的更新特定元素的值啊?要知道,priority_queue 只支援「推入」,是沒有「更新」這種操作的!
這裡就要介紹一個巧妙的實作方式,又被稱為「Lazy deletion」,概念是這樣的:當有數值要被更新時,我們也不管裡面存著舊的值,直接把新的值推進 priority_queue 裡面就好。這是因為我們可以記錄「最新版本的數值」,這樣每次數值拿出來時,我們只需要比對拿出來的數值是否與當前版本的數值吻合,只要不吻合,就直接無視它,這樣就可以在結果上達成「只有真正的數值會被拿出來用」的效果。
直接看程式碼也許更好理解一些:
typedef pair<long long, int> state; // 使用(距離,編號)的 pair 來儲存一個可能的最短路狀態
priority_queue<state, vector<state>, greater<state>> pq; // 因為 priority_queue 預設是回傳最大值,要特別傳參數讓他變成 min heap
dis[s] = 0;
pq.emplace(dis[s], s);
while (!pq.empty()) {
    auto [d, u] = pq.top();
    pq.pop();
    if (dis[u] != d) continue; // 與當前版本數值不符!
    for (auto [v, w] : G[u])
        if (dis[v] > dis[u] + w) {
            dis[v] = dis[u] + w;
            pq.emplace(dis[v], v); // 不管怎樣,推進去就對了
        }
}
做了這個優化後,我們也就不需要在每個點拿出來時花 $O(N)$ 的時間找最小值,但要注意到,所有邊被使用來鬆弛時都有可能觸發一次推東西進 priority_queue 的機會,推進 priority_queue 其實就象徵著 $O(\log M)$ 的花費。因此,整體的時間複雜度就是 $O(M\log M)$,在 $N$ 跟 $M$ 大小差不多時是非常良好的進步!
關於「Lazy deletion」
Lazy deletion 其實在任何跟「需要更新 priority_queue 內的數值」時都相當好用,但要特別注意的是,我們可以在拿出東西時只用「dis[u] != d」這種比對數值的方式來檢查是一個更為偷懶的寫法,這是因為我們保證每次要「更新數值」時,數值只會嚴格的變小,所以不會發生相同數值被拿出來好幾次的問題。
那什麼情況會出事呢?如果鬆弛那邊超偷懶寫成這樣的話:
for (auto [v, w] : G[u]) {
    dis[v] = min(dis[v], dis[u] + w);
    pq.emplace(dis[v], v);
}
就可以構造測試資料來讓程式跑到指數時間!此時如果想要從 Lazy deletion 的角度修正的話,很有可能會需要幫推進去的變數多加上一個「版本編號」,來辨識拿到的東西是否是對應的版本;從 Dijkstra's 演算法的角度來看,也可以多宣告一個 vis[] 陣列,在一個點從 priority_queue 拿出來時,直接把它的 vis[u] 標成 true,這樣下次再拿同樣的點出來時,看到 vis[u] 是 true 就可以直接 continue 了。
上面兩種修正方式都可以讓同樣的超偷懶寫法重新修正回 $O(M\log M)$,這部份就交給讀者自行想清楚了。
我們上面實作的 Dijkstra's 演算法後面帶著 $O(\log M)$ 的原因,其實就是因為我們使用了 Lazy deletion,導致 priority_queue 裡面可能會裝著 $O(M)$ 個元素。因此,如果真的能夠達成「動態更新數值、動態回報最小值」,priority_queue 裡面就可以只有至多 $N$ 個元素,就可以變成 $O(M\log N)$ 的時間。
不過要知道,如果有兩條邊連接的 $(u, v)$ 相同,那其實只需要保留權重比較小的那條就好,也就是說任一對有序的數對之間也只有一條邊,表示 $M=O(N^2)$,所以 $O(\log M)$ 跟 $O(\log N)$ 根本是一樣的。
如果要再優化,可以從 priority_queue 這個用來當作 min heap 的資料結構下手:其實有一種 heap 叫做 Fibonacci heap,可以達到「均攤 $O(1)$ 動態更新數值、均攤 $O(\log N)$ 回報並移除最小值」,這樣一來,每次鬆弛的時間就是 $O(1)$,而移除最小值只會發生 $N$ 次,所以整體可以優化到 $O(M+N\log N)$!
不過,Fibonacci heap 的常數相當巨大,不管是在競賽程式還是實務上用處都不太大,所以這裡只是作為一個科普用,在比賽時還是用前面的 Lazy deletion 實作方式就很足夠了。
要證明 Dijkstra's 演算法的正確性,其實有另一個直觀的看法。再次回想我們在圖論基礎學過的不帶權最短路,不妨我們直接在「權重 $w$ 的邊」中間塞上「$w-1$」個點連成一直線,並讓這 $w+1$ 個點之間都改成連權重 $1$ 的邊,如此就變成一張超級巨大、但邊權都變回 $1$ 的圖。
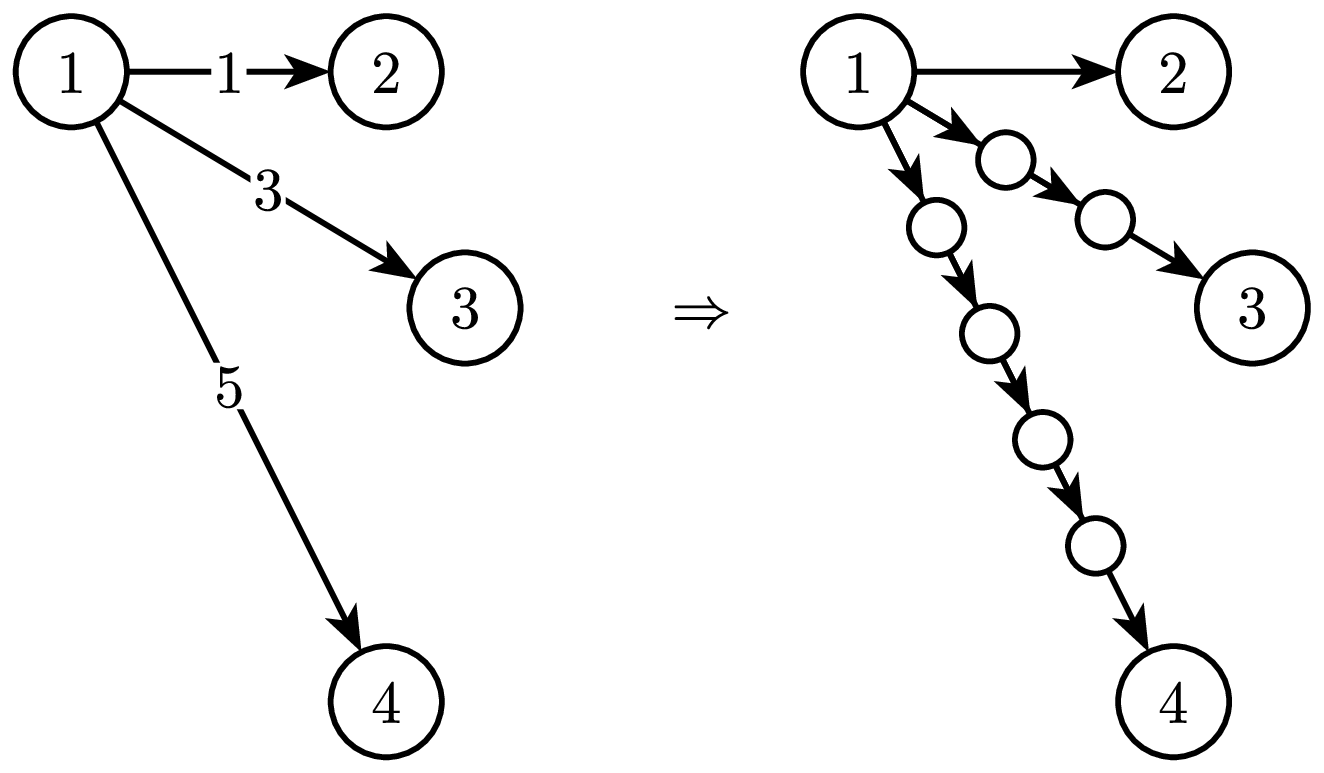
這時候我們再從起點開始進行 BFS,就會發現點被從 queue 中拿出來的順序,跟 Dijkstra's 演算法拿點出來的順序是一樣的,只是我們「跳過」了中間那些多加的、沒有實質意義的的點而已。用這樣的角度去思考,相信「當前距離最短的點身上的最短路已經被確定、不會再更新了」的性質就會更好接受了。
這種「跳過」的概念也可以應用在最短路徑以外的題目上,其核心想法就是試圖把這種「沒有意義的過程」壓縮起來,利用 min heap 就可以找出下一個「有影響的事件」在哪。由於有些偏離本文主題,若有機會,我們會再開一篇文章來講解這種技巧。
旅遊優惠券
皮皮經常穿梭世界各地,也因此他拿到了航空公司的優惠券,可以免費搭乘一趟飛機。假設世界上一共有 $N$ 個編號 $1\sim N$ 的城市以及 $M$ 條票價不盡相同的航線。皮皮想要從 $S$ 城市出發到 $T$ 城市,中間可能要經過幾趟轉機才能到達,但是免費優惠券只能用在途中的一條航班上,而其他航班仍須正常收費。請問皮皮的最小花費為何。
條件限制
- $2\le N\le 10^ 5$
- $1\le M\le 10^ 5$
- $1\le w\le 10^ 9$
- $1\le S, T, u, v\le N, S\ne T, u\ne v$
Number Maze
給你一 $N\times M$ 的數字迷宮,你可以用直角方向 (東、西、南、北) 在迷宮中尋訪,求從左上角走到右下角所需的最小成本。
條件限制
- $1 \leq N,M \leq 999$
穿越福文大地
充滿戰亂的福文大地上共有 $N$ 座城市,城市之間共有 $M$ 條雙向道路。
每次經過一條道路,就會被駐守在該地的聯盟軍攻擊,損失 $C_i$ 的血量。
同時每經過一座城市,就會被收取 $f_i$ 的過路費 (包括起點和終點)。
小晨攜帶著蒂瑪西亞人民的希望,從城市 $1$ 出發,要穿越重重危險到達城市 $N$ 尋求戰力支援。
出發時小晨的血量為 $H$ ,請你考慮所有血量不降到負數且到達城市 $N$ 的的路線中,能最小化路線上「最多的那次城市過路費」的路線並輸出該費用。
如果無論如何小晨都無法順利到達城市 $N$,請你輸出 $-1$。
條件限制
- $N \le 10^ 4$
- $M \le 5\times 10^ 4$
- $1 \le a,b \le N$ 且 $a \neq b$
- $H,c,f_i \le 10^ 9$